SecOps : ce que fait vraiment une équipe entre la première alerte et la reprise d’activité
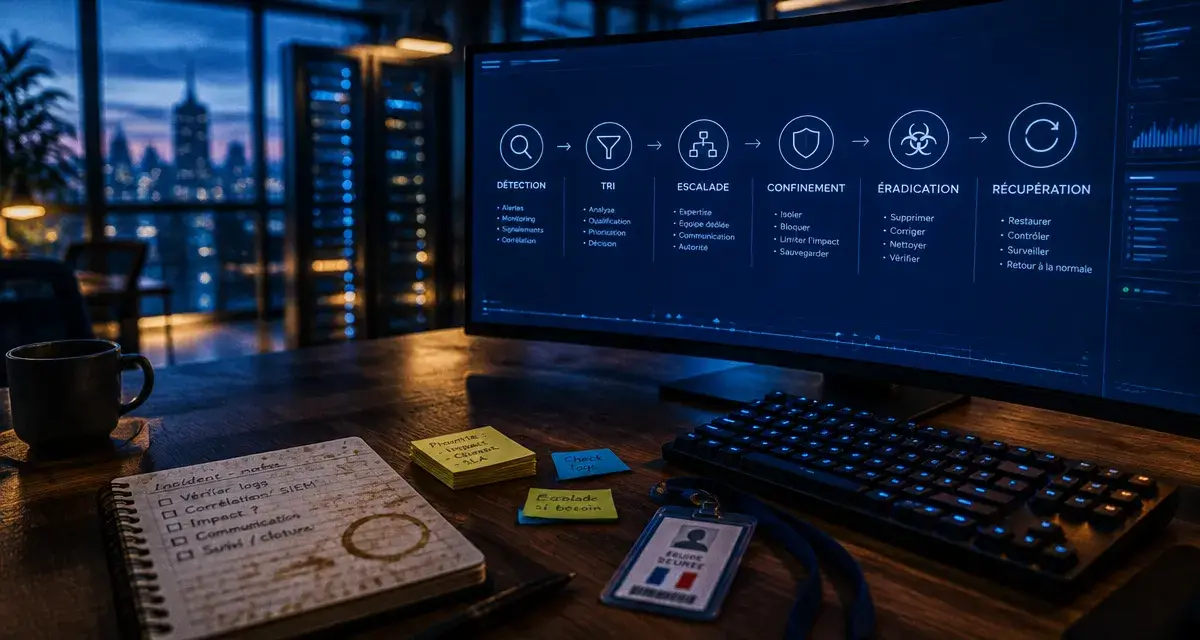
SecOps, contraction de Security Operations (opérations de sécurité), désigne la façon dont une organisation fait travailler ensemble ses équipes de sécurité et ses équipes d’exploitation IT pour détecter, comprendre et contenir les cybermenaces au quotidien. Plutôt qu’un produit ou une équipe isolée, c’est un mode de fonctionnement qui réunit des personnes, des processus et des technologies autour d’un même objectif : réduire le risque et limiter l’impact d’un incident.
SecOps : une définition qui part du terrain
Sécurité et opérations IT dans la même boucle
Dans un modèle classique, la sécurité fixe des règles et contrôle a posteriori, pendant que l’exploitation IT maintient les systèmes en état de marche. Les deux univers se croisent souvent trop tard, au moment d’un incident. L’approche SecOps supprime cette frontière : les équipes partagent la même visibilité, les mêmes alertes et une responsabilité partagée sur la protection des systèmes, des réseaux, des applications, des données et des utilisateurs.
Quiz : testez vos connaissances sur SecOps
Répondez aux questions, puis validez vos réponses pour découvrir votre score.
Un périmètre qui dépasse le datacenter
La surveillance couvre les terminaux, les identités, les e-mails, les applications et les infrastructures, qu’elles soient locales, cloud, hybrides ou multicloud. Plus la surface d’attaque s’étend, plus il devient difficile de protéger chaque brique séparément, et plus la logique d’ensemble de SecOps prend son sens.
SecOps, SOC, cybersécurité traditionnelle : où sont les différences ?
Ces termes sont souvent employés l’un pour l’autre, alors qu’ils ne désignent pas la même chose. Le SOC (centre des opérations de sécurité) est la structure qui surveille et traite les alertes. SecOps est la démarche plus large dans laquelle ce centre s’inscrit, avec son lien aux équipes IT, sa gouvernance et son amélioration continue. La cybersécurité traditionnelle, elle, reste souvent centrée sur la prévention et le contrôle, avec des outils cloisonnés.
| Notion | Ce que c’est | Rôle principal |
|---|---|---|
| SecOps | Une démarche d’ensemble | Aligner sécurité et opérations IT |
| SOC | Une équipe et un centre de supervision | Surveiller, trier, investiguer |
| SIEM | Un outil de collecte et de corrélation | Centraliser les journaux et déclencher des alertes |
| SOAR | Une plateforme d’orchestration | Automatiser les tâches répétitives |
| XDR | Une détection et réponse étendues | Unifier la télémétrie de plusieurs surfaces |
| EDR / PEPT | Une protection des points de terminaison | Détecter et répondre sur les postes et serveurs |
Le SOC est donc l’un des organes de SecOps, pas son synonyme.
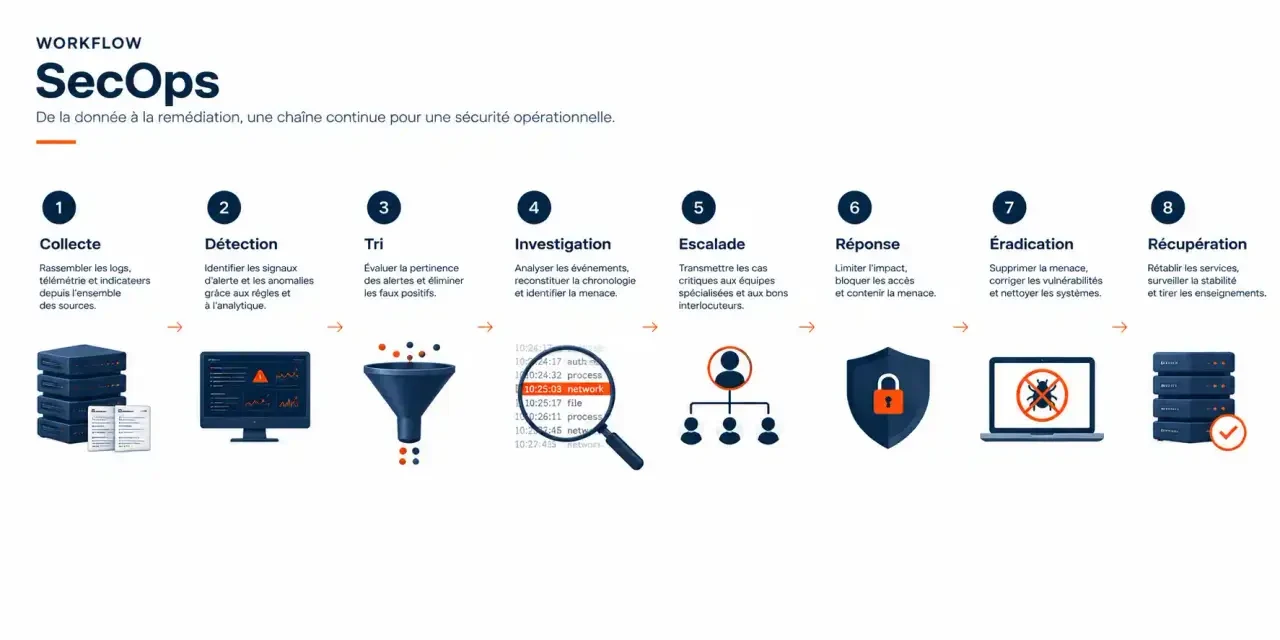
Le workflow d’un incident, de l’alerte à la récupération
Détecter, trier, qualifier
Tout commence par la supervision continue : les journaux et la télémétrie remontent vers un point central, où la corrélation d’événements fait ressortir les signaux utiles. Une connexion suspecte, un indicateur de compromission ou un comportement de logiciel malveillant génère une alerte. Le tri sépare ensuite le bruit et les faux positifs du risque réel, en s’appuyant sur le contexte : quel système, quelle identité, quelle criticité.
Escalader, contenir, éradiquer, récupérer
Lorsqu’une alerte est qualifiée d’incident, elle est escaladée vers les personnes compétentes. Vient alors le confinement du système touché pour empêcher la propagation, puis l’éradication de la menace et la remise en service. Un rançongiciel, par exemple, impose d’isoler rapidement les machines concernées avant même de comprendre l’intégralité de la chaîne d’attaque. Le cycle se termine par un retour d’expérience : documenter, ajuster les règles de détection, corriger la cause.
Penser en verrous successifs
Une image aide à relire ce workflow : chaque étape agit comme un verrou posé sur le chemin de l’attaquant. La détection referme la porte d’entrée, la qualification empêche qu’une alerte reste ouverte, le confinement bloque le déplacement latéral d’un système à l’autre, l’éradication retire la clé qu’il aurait copiée (comptes compromis, accès persistants). Cette lecture a une conséquence pratique : un verrou qui manque ou qui cède en silence, par exemple une source de journaux non collectée, rend inutiles tous les autres. Cartographier vos verrous, et vérifier lesquels sont réellement surveillés, est un excellent exercice pour repérer vos angles morts.
Les outils qui font tourner un programme SecOps
Le SIEM collecte, analyse et corrèle les journaux : c’est la mémoire et le détecteur du dispositif. Le SOAR orchestre et automatise les actions récurrentes (enrichir une alerte, isoler un poste, ouvrir un ticket), ce qui libère les analystes pour les tâches d’analyse. Le XDR rassemble la télémétrie des terminaux, e-mails, identités, clouds et réseaux afin de suivre la progression d’une attaque sur plusieurs surfaces. L’EDR, ou PEPT, protège les points de terminaison et permet d’y répondre précisément. Enfin, les solutions de sécurité cloud protègent données, applications et charges de travail dans les environnements hybrides et multicloud.
Le machine learning et l’IA aident à hiérarchiser les alertes, mais ils ne remplacent pas le jugement humain. Une automatisation gouvernée, avec des cas où l’analyste valide avant l’action, reste la voie la plus sûre. Le renseignement sur les menaces et la chasse aux menaces complètent la détection par alertes en cherchant activement ce que les règles n’ont pas vu.
Bénéfices, obstacles et mise en place
Ce que l’entreprise y gagne
Une visibilité centralisée et continue permet de détecter plus tôt et de répondre plus vite, ce qui réduit l’impact des violations, les interruptions de service et les pertes financières. La traçabilité des actions soutient la conformité et la gouvernance, qu’il s’agisse du RGPD, de l’ISO, du NIST ou de PCI DSS. La collaboration entre IT et sécurité diminue enfin les silos qui ralentissent la réponse.
Les défis à anticiper
Les freins sont connus : volume d’alertes difficile à absorber, pénurie de talents en cybersécurité, outils en silos et manque de visibilité sur certaines parties du système d’information. Ils se traitent par la priorisation, l’automatisation raisonnée et l’intégration des outils plutôt que par leur multiplication.
Par où commencer
- Cartographier les actifs, les environnements et les sources de journaux à superviser.
- Définir les rôles : analystes, responsable SecOps, équipe IT, lien avec le CISO.
- Documenter les processus de tri, d’escalade et de réponse, avec des playbooks pour les scénarios fréquents.
- Choisir les outils en fonction de l’existant et de leur capacité à s’intégrer entre eux.
- Arbitrer entre équipe interne, service managé ou modèle mixte selon vos ressources.
- Mesurer et améliorer : temps de détection, temps de réponse, taux de faux positifs, couverture de supervision.
Une petite structure peut démarrer avec un périmètre restreint et un service externalisé, puis élargir au fil de sa maturité. L’essentiel est que la démarche soit continue : SecOps n’est pas un projet qu’on livre, c’est une discipline qu’on entretient.
Articles qui pourraient vous intéresser :
 Audit IT : 4 leviers pour transformer vos risques technologiques en performance durable
 Dématérialiser : définition, enjeux et distinction avec la numérisation
 Modèle de données : les 3 niveaux à connaître, avec exemples métier et erreurs à éviter
 L’event technology transforme l’événement, à condition de servir l’expérience